MarkdownCo

PDF в Markdown
Извлечение для LLM и RAG

Извлекайте текст и таблицы из любого PDF в чистый, структурированный Markdown — готовый для RAG-пайплайнов, ChatGPT и векторных баз данных.

Умный макетВосстановление таблицБезопасно

Связанные инструменты конвертации Markdown

Попробуйте другие конвертеры Markdown для вашего рабочего процесса

Как конвертировать PDF в Markdown онлайн

Извлеките текст и таблицы из PDF в чистый Markdown за три шага.

Шаг 1

Загрузите ваш PDF

Перетащите PDF-файл в область загрузки или нажмите для обзора. Мы поддерживаем текстовые PDF до 10 МБ — экспортированные из Word, LaTeX, Google Docs или любого другого инструмента.

Шаг 2

Автоматическое извлечение

Наш движок парсинга анализирует структуру PDF и восстанавливает заголовки, абзацы, списки, таблицы и блоки кода в чистый Markdown.

Шаг 3

Скачайте Markdown

Мгновенно скачайте конвертированный файл .md — он сразу готов для Git или вашего редактора.

Популярные сценарии: PDF в Markdown

От научных статей до RAG-пайплайнов — вот что пользователи ежедневно извлекают в чистый Markdown.
Перенесите устаревшую PDF-документацию в Markdown с контролем версий через Git
Извлекайте контент из научных статей для Obsidian, Notion или личных баз знаний
Переработайте PDF-отчёты и white paper в редактируемые статьи для блога или страницы вики
Конвертируйте закрытый PDF-контент в поисковый, редактируемый Markdown для долгосрочного хранения

Лучший бесплатный конвертер PDF в Markdown — возможности и преимущества

Конвертируйте PDF в чистый, редактируемый Markdown с помощью нашего продвинутого движка парсинга. Точно восстанавливает заголовки, таблицы, блоки кода и структуру документа из PDF-файлов.

Восстановление вёрстки

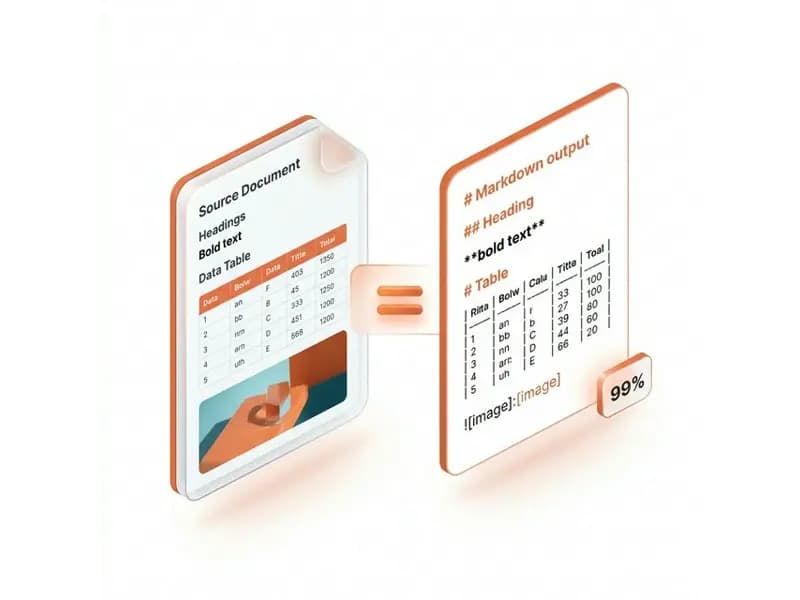
Наш конвертер PDF в MD анализирует структуру PDF-документа для корректной идентификации и восстановления заголовков (H1–H6), абзацев, маркированных и нумерованных списков, а также цитат — сохраняя логический поток и иерархию документа в чистом Markdown.
Восстановление вёрстки

Таблицы остаются таблицами

Сложные таблицы в PDF обнаруживаются и конвертируются в чистый GFM-совместимый синтаксис таблиц Markdown при конвертации PDF в Markdown. Выравнивание столбцов, заголовки и содержимое ячеек сохраняются — результат готов к редактированию в любом Markdown-редакторе.
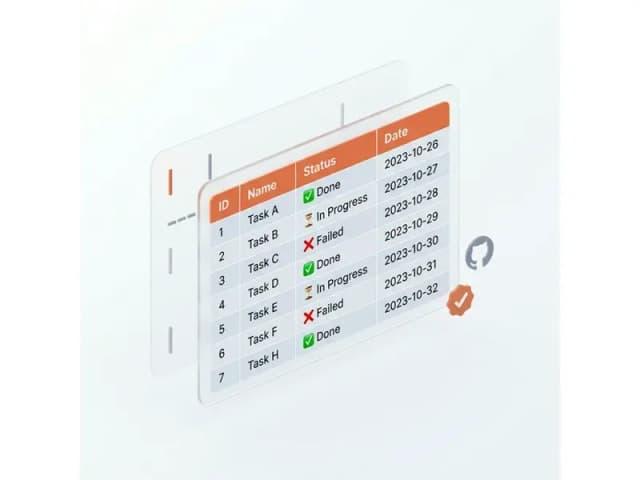
Таблицы остаются таблицами

Приватно и безопасно

Ваши PDF-файлы передаются в зашифрованном виде, конвертируются в Markdown на наших собственных серверах и хранятся в защищённом облачном хранилище. Мы никогда не продаём ваш контент и не используем его для обучения ИИ-моделей.
Приватно и безопасно

Блоки кода сохраняются

Наш конвертер PDF в MD обнаруживает секции кода в технических PDF-документах и оборачивает их в правильные огороженные блоки кода Markdown (```), делая их сразу пригодными для README-файлов, документации разработчиков и технических вики.
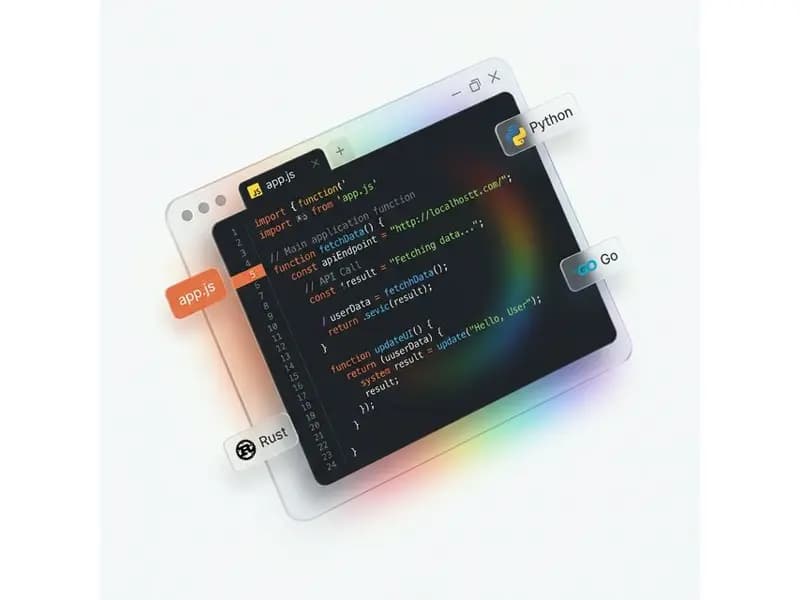
Блоки кода сохраняются

Конвертация PDF в Markdown — часто задаваемые вопросы

Ответы о том, как конвертер PDF в Markdown обрабатывает вёрстку, таблицы и точность извлечения.

Для чего можно использовать конвертацию PDF в Markdown?

Конвертация PDF в MD позволяет извлечь и повторно использовать содержимое документа в чистом, редактируемом формате с контролем версий. Типичные сценарии: перенос устаревшей PDF-документации в Git-репозитории Markdown на GitHub или GitLab, конвертация научных статей в Markdown для баз знаний Obsidian или Notion, переработка PDF-отчётов и white paper в редактируемые статьи блога или вики-страницы для генераторов статических сайтов (Hugo, Jekyll, Docusaurus), а также включение ранее закрытого PDF-контента в систему контроля версий с отслеживанием изменений.

Сохраняет ли конвертер PDF в Markdown исходную структуру документа?

Да — конвертер PDF в Markdown сохраняет исходную структуру документа. Наш парсер PDF в MD восстанавливает заголовки (H1–H6), абзацы, маркированные и нумерованные списки, цитаты и блоки кода из макета PDF. Конвертер анализирует иерархию документа и размеры шрифтов для корректного определения уровней заголовков. Сложные многоколоночные макеты или PDF с насыщенным дизайном и нестандартной типографикой могут быть упрощены для получения чистого, читаемого Markdown, который работает в любом Markdown-редакторе.

Сохраняются ли изображения из PDF при конвертации PDF в Markdown?

Да — MarkdownCo встраивает изображения из PDF прямо в файл Markdown в виде данных base64, поэтому .md открывается вместе со всеми изображениями. Отдельная папка с изображениями или ZIP-архив не создаются. Встроенные изображения увеличивают размер файла, так что PDF с большим количеством картинок дают более объёмные .md-файлы.

Может ли конвертер PDF в MD извлекать таблицы в формат Markdown?

Да — MarkdownCo превращает таблицы из PDF в таблицы Markdown (GFM). Наш конвертер PDF в Markdown обнаруживает табличные структуры в PDF и преобразует их в GFM-совместимый синтаксис таблиц Markdown с правильными заголовками столбцов и выравниванием. Обратите внимание: сильно объединённые ячейки или визуально сложные таблицы с colspan/rowspan могут быть упрощены для получения чистого, валидного вывода таблиц Markdown, пригодного для редактирования.

Распознаёт ли конвертер PDF в Markdown блоки кода?

Да — MarkdownCo превращает код из PDF в огороженные блоки кода Markdown. Наш конвертер PDF в Markdown определяет секции кода в технических PDF-документах — обычно набранные моноширинными шрифтами, такими как Courier — и оборачивает их в огороженные блоки кода Markdown (```). Это делает код сразу пригодным для документации разработчиков, README-файлов, технических вики и GitHub-репозиториев.

Сохраняются ли гиперссылки при конвертации PDF в MD?

Да — MarkdownCo сохраняет гиперссылки из PDF как ссылки Markdown. Кликабельные гиперссылки в PDF конвертируются в стандартный синтаксис ссылок Markdown [отображаемый текст](url) при конвертации PDF в Markdown, сохраняя как видимый текст, так и целевой URL. Поддерживаются как внутренние ссылки документа, так и внешние URL.

Какие типы PDF-файлов лучше всего подходят для конвертации в Markdown?

Текстовые PDF дают лучшие результаты при конвертации PDF в MD — это PDF, созданные экспортом из Microsoft Word, LaTeX, Google Docs, Apple Pages или другого программного обеспечения. Текстовый слой в них доступен напрямую, что позволяет конвертеру точно извлекать заголовки, абзацы, списки и таблицы. Сканированные PDF и PDF-изображения на данный момент не поддерживаются, так как требуют технологии OCR (оптического распознавания символов). Защищённые паролем PDF необходимо разблокировать перед конвертацией в Markdown.

Каков лимит размера файла при конвертации PDF в Markdown?

Максимальный поддерживаемый размер при конвертации PDF в Markdown — 10 МБ на файл. Этого достаточно для большинства технических документов, научных статей, отчётов и электронных книг. Каждая конвертация использует 1 кредит. Каждый получает 1 бесплатную конвертацию в день без регистрации, а бесплатный аккаунт дополнительно даёт 3 приветственных кредита.

Сколько времени занимает конвертация PDF в Markdown?

Большинство стандартных конвертаций PDF в Markdown завершаются за несколько секунд. Файлы большего размера или документы с множеством встроенных изображений могут занять до 30 секунд. В процессе конвертации отображается индикатор прогресса для отслеживания статуса в реальном времени.

Мои PDF-файлы в безопасности при конвертации в Markdown?

Да — MarkdownCo передаёт ваш PDF по HTTPS и конвертирует его на собственных серверах. PDF и полученный Markdown хранятся в защищённом облачном хранилище; мы никогда не продаём их и не используем для обучения ИИ-моделей.

Связанные руководства и статьи

Узнайте больше из пошаговых руководств и советов в нашем блоге.