MarkdownCo

PDF → Markdown 変換
LLM対応抽出・RAG向け

あらゆるPDFからテキスト・表を抽出し、クリーンで構造化されたマークダウン(Markdown)に。RAGパイプライン・ChatGPT・ベクトルデータベースにそのまま使えます。

スマートレイアウト表の復元安全

PDFをMarkdownに変換する方法

3つのステップで、PDFからテキスト・表を抽出してクリーンなMarkdownにします。

ステップ1

PDFをアップロード

PDFファイルをアップロードエリアにドラッグ&ドロップするか、クリックして参照します。Word、LaTeX、Google Docsなどから出力されたテキストベースのPDF(最大10 MB)に対応しています。

ステップ2

自動抽出

解析エンジンがPDFの構造を分析し、見出し、段落、リスト、表、コードブロックをクリーンなMarkdownに再構築します。

ステップ3

Markdownをダウンロード

変換された.mdファイルを即座にダウンロードできます。Gitやエディタですぐに使えます。

PDF → Markdown のよくある活用シーン

研究論文から RAG パイプラインまで、みんなが毎日 クリーンな Markdown に抽出しているものを紹介します。
レガシーなPDFドキュメントをGit管理のMarkdownに移行してバージョン管理
研究論文からコンテンツを抽出し、ObsidianやNotionのナレッジベースで活用
PDFレポートやホワイトペーパーをブログ記事やWikiページに転用
ロックされたPDFコンテンツを検索・編集可能なMarkdownに変換して長期保存

最高の無料PDF→Markdown変換ツール — 機能とメリット

高度な解析エンジンでPDFをクリーンで編集可能なMarkdownに変換します。PDFファイルから見出し、表、コードブロック、ドキュメント構造を正確に再構築します。

レイアウトの復元

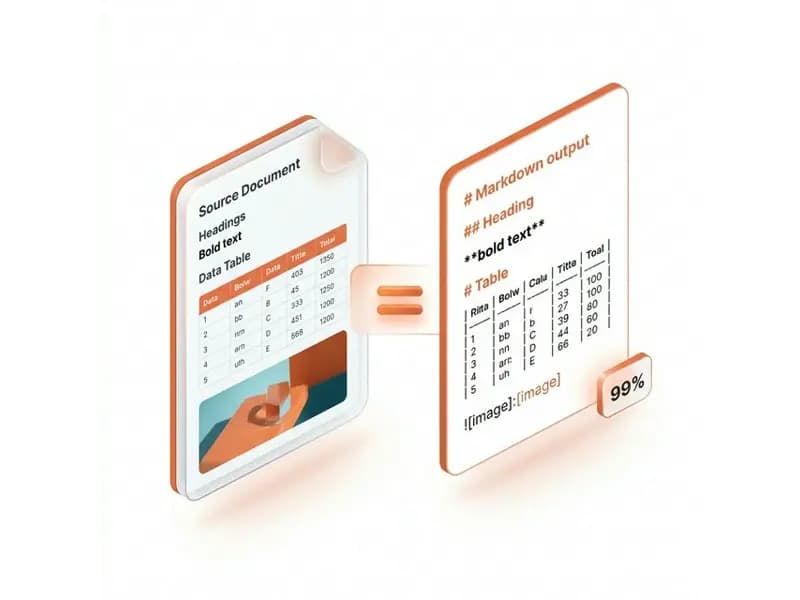
PDF→Markdownコンバーターは、PDFのドキュメント構造を分析して見出し(H1〜H6)、段落、箇条書きリスト、番号付きリスト、ブロッククォートを正しく識別・再構築し、クリーンなMarkdown構文でドキュメントの論理的な流れと階層を保持します。
レイアウトの復元

表は表のまま

PDF内の複雑な表はPDF→Markdown変換時に検出され、クリーンなGFM互換のMarkdown表構文に変換されます。列の配置、ヘッダー、セルの内容が保持され、任意のMarkdownエディタで編集可能です。
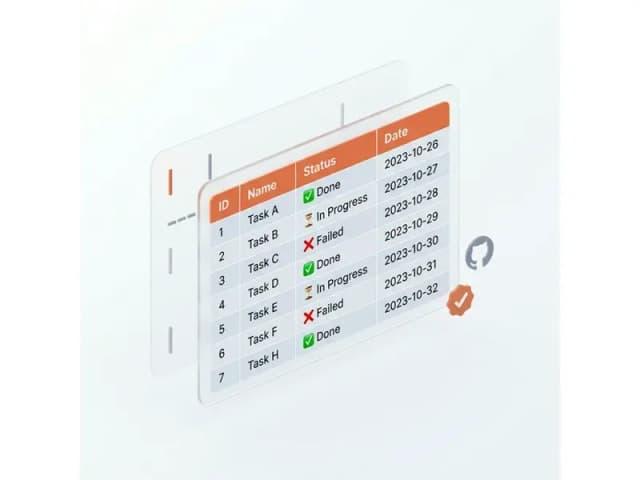
表は表のまま

プライベート&安全

PDFファイルは暗号化して転送され、自社サーバーでMarkdownに変換されたうえで、安全なクラウドストレージに保管されます。コンテンツを販売したり、AIモデルの学習に使用したりすることはありません。
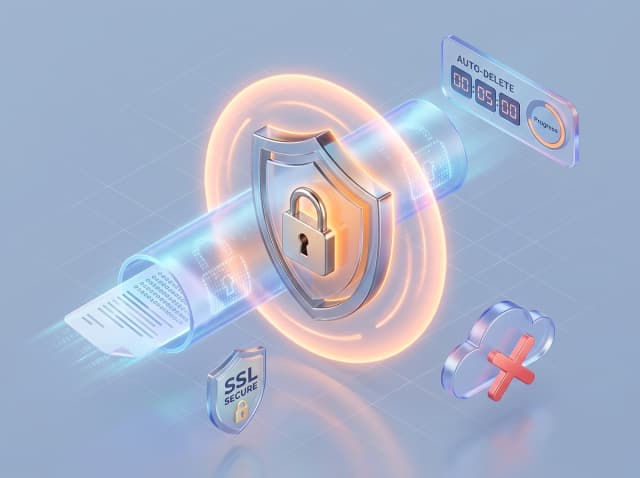
プライベート&安全

コードブロックを保持

PDF→Markdownコンバーターは技術的なPDFドキュメント内のコードセクションを検出し、適切なMarkdownフェンスコードブロック(```)でラップします。READMEファイル、開発者向けドキュメント、技術Wikiですぐに活用できます。
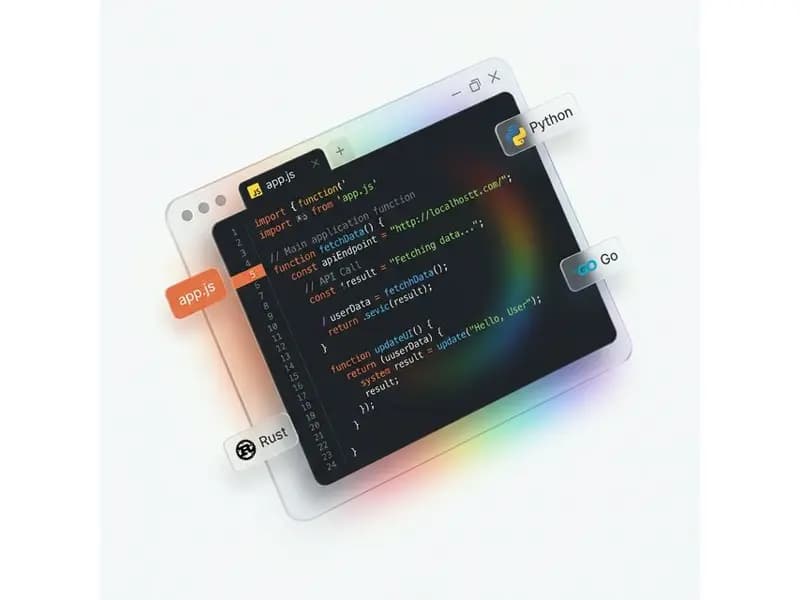
コードブロックを保持

PDF→Markdown変換 — よくある質問

PDF → Markdown 変換ツールがレイアウト・表・抽出精度をどう扱うかの回答。

PDF→Markdown変換はどのような用途に使えますか?

PDFをMarkdownに変換することで、ドキュメントのコンテンツをクリーンで編集可能な、バージョン管理可能な形式で抽出・再利用できます。一般的な用途には、レガシーなPDFドキュメントをGitHubやGitLabのGit管理Markdownリポジトリに移行する、学術研究論文をObsidianやNotionのナレッジベース向けMarkdownに変換する、PDFレポートやホワイトペーパーをHugo、Jekyll、Docusaurusなどの静的サイトジェネレーター向けに編集可能なブログ記事やWikiページに転用する、従来ロックされていたPDFコンテンツのバージョン管理とdiffトラッキングを可能にする、などがあります。

PDF→Markdown変換ツールは、元のドキュメント構造を保持しますか?

はい。PDF→Markdown変換ツールは元のドキュメント構造を保持します。PDF→Markdown解析エンジンは、PDFレイアウトから見出し(H1〜H6)、段落、箇条書きリスト、番号付きリスト、ブロッククォート、コードブロックを再構築します。コンバーターはドキュメントの階層とフォントサイズを分析して見出しレベルを正しく識別します。複雑な多カラムレイアウトやカスタムタイポグラフィで重度にデザインされたPDFは、任意のMarkdownエディタで動作するクリーンで読みやすいMarkdownを確保するために簡略化される場合があります。

PDFをMarkdownに変換するとき、PDF内の画像は残りますか?

はい。MarkdownCoはPDF内の画像をbase64データとしてMarkdownファイルに直接埋め込むため、.mdファイルを開くと画像もそのまま表示されます。画像を別フォルダやZIPとして出力することはありません。画像を埋め込む分ファイルサイズは大きくなるため、画像の多いPDFほど.mdファイルも大きくなります。

PDF→MarkdownコンバーターでPDFの表をMarkdown形式に抽出できますか?

はい。MarkdownCoはPDF内の表をMarkdown(GFM)の表に変換します。PDF→Markdownコンバーターは、PDF内の表構造を検出し、適切な列ヘッダーと配置を持つGFM互換のMarkdown表構文に変換します。セルが大幅に結合されていたり、colspan/rowspanを使った視覚的に複雑な表は、任意のMarkdownエディタで編集できるクリーンで有効なMarkdown表出力を生成するために簡略化される場合があります。

PDF→Markdown変換ツールはコードブロックを検出して抽出できますか?

はい。MarkdownCoはPDF内のコードを、フェンス付きのMarkdownコードブロックに変換します。PDF→Markdownコンバーターは技術的なPDFドキュメント内のコードセクション(通常Courierなどの等幅フォントでレンダリングされている)を識別し、Markdownのフェンスコードブロック(```)でラップします。これにより、開発者向けドキュメント、READMEファイル、技術Wiki、GitHubリポジトリですぐに活用できます。

PDF→Markdown変換時にハイパーリンクは保持されますか?

はい。MarkdownCoはPDF内のハイパーリンクをMarkdownリンクとして保持します。PDF内のクリック可能なハイパーリンクはPDF→Markdown変換時に標準のMarkdownリンク構文 [表示テキスト](url) に変換され、表示テキストとリンク先URLの両方が保持されます。ドキュメント内部のリンクと外部WebURLの両方がキャプチャされます。

PDF→Markdown変換に最も適したPDFファイルの種類は?

テキストベースのPDFがPDF→Markdown変換に最適です — これらはMicrosoft Word、LaTeX、Google Docs、Apple Pages、その他の文書作成ソフトウェアからエクスポートして作成されたPDFです。テキストレイヤーに直接アクセスでき、コンバーターが見出し、段落、リスト、表を正確に抽出できます。スキャンされたPDFや画像のみのPDFはOCR(光学文字認識)技術が必要なため、現在サポートされていません。パスワード保護されたPDFは、Markdownに変換する前にパスワードを解除する必要があります。

PDF→Markdown変換のファイルサイズ制限はどれくらいですか?

PDF→Markdown変換の最大対応ファイルサイズは1ファイルあたり10 MBです。ほとんどの技術ドキュメント、研究論文、レポート、電子書籍には十分です。各変換には1クレジットが必要です。登録不要で毎日1回まで無料変換でき、無料アカウント登録でさらに3クレジットがもらえます。

PDFからMarkdownへの変換にはどれくらい時間がかかりますか?

標準的なPDF→Markdown変換のほとんどは数秒で完了します。ファイルサイズが大きいPDFや埋め込み画像が多いドキュメントは最大30秒かかる場合があります。PDF→Markdown変換の実行中はリアルタイムの進捗インジケーターが表示され、ステータスを追跡できます。

PDF→Markdown変換時にPDFファイルは安全に管理されますか?

はい。MarkdownCoはPDFをHTTPSで転送し、自社サーバーで変換します。PDFと変換後のMarkdownは安全なクラウドストレージに保管され、販売したりAIモデルの学習に使用したりすることはありません。

関連ガイド・記事

ブログのステップバイステップのガイドとヒントで、さらに詳しく学べます。